La inteligencia artificial lleva años transformando la ciencia de datos, pero desde la llegada de la IA generativa el cambio se ha acelerado. Ya no se trata solo de entrenar mejores modelos predictivos: hoy los modelos escriben código, entienden documentos y actúan sobre otras herramientas. Repasamos qué ha cambiado y qué significa para quien trabaja con datos.
De los modelos a medida a los modelos fundacionales
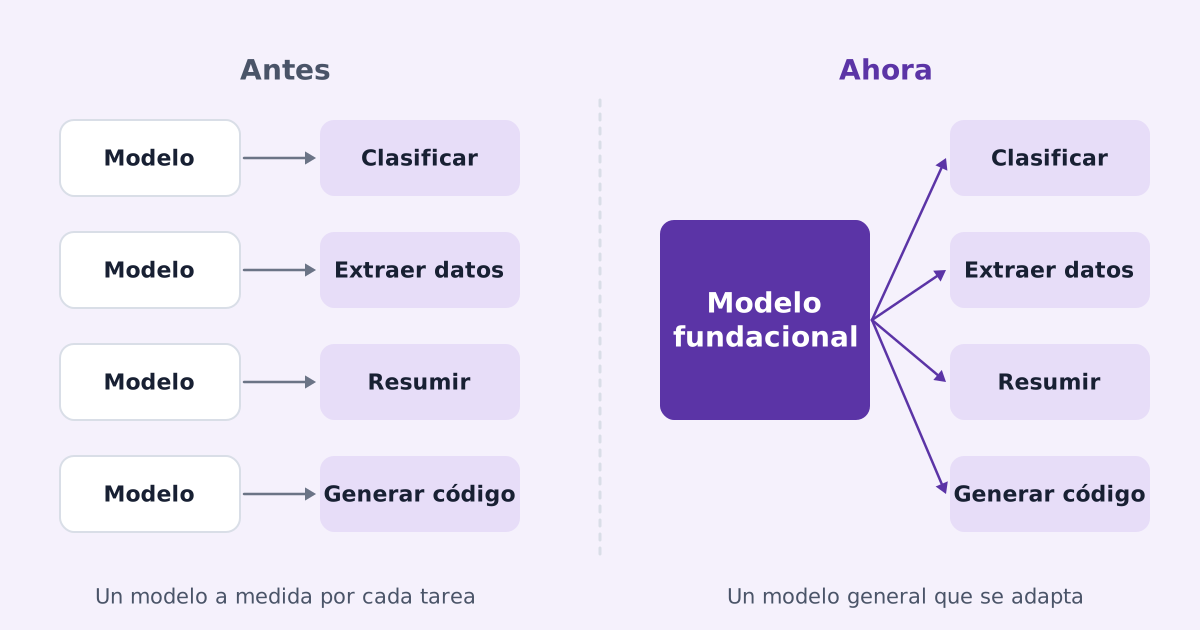
Durante años, aplicar IA significaba entrenar un modelo para cada problema con datos propios: uno para prever la demanda, otro para clasificar incidencias, otro para detectar fraude. Ese enfoque sigue vigente, sobre todo con datos tabulares.
A su lado han aparecido los modelos fundacionales: modelos enormes, preentrenados con grandes volúmenes de texto, imágenes o código, que se adaptan a una tarea concreta sin entrenarlos de nuevo. Basta con darles buenas instrucciones, conectarlos a documentos propios mediante RAG o, si hace falta, ajustarlos con técnicas de fine-tuning. Elegir entre un modelo clásico y uno fundacional, y entre estas formas de adaptarlo, se ha convertido en una decisión central del trabajo. Lo explicamos en RAG, fine-tuning o prompting.
Automatización: de AutoML a los asistentes y agentes
Herramientas de AutoML como Auto-sklearn o H2O automatizaron la selección de modelos y el ajuste de hiperparámetros. Hoy los asistentes y agentes de código van más allá: escriben el código de limpieza, generan consultas SQL, preparan notebooks y ejecutan pruebas.
El efecto es doble. Se dedica menos tiempo a tareas repetitivas y más a formular la pregunta y validar el resultado. Pero aparece un riesgo nuevo: código que parece correcto y no lo es. Revisar lo que produce la IA es ya una habilidad básica.
El dato no estructurado pasa a primer plano
Correos, contratos, informes, transcripciones o imágenes eran difíciles de aprovechar sin grandes conjuntos de datos etiquetados. Los modelos de lenguaje y los modelos multimodales permiten clasificarlos, extraer información o resumirlos con pocas o ninguna etiqueta. Los embeddings y las bases de datos vectoriales hacen posible buscar por significado, no solo por palabras exactas.
Deep learning en todas partes
El aprendizaje profundo sigue detrás de la mayoría de avances:
- Visión artificial: análisis de imagen médica, inspección de calidad en fábricas, lectura de documentos.
- Lenguaje: asistentes, traducción, análisis de opiniones, extracción de datos de textos.
- Series temporales: previsión de demanda, mantenimiento predictivo, análisis financiero.
De modelos sueltos a sistemas de IA
Las empresas ya no despliegan un modelo aislado, sino sistemas: un asistente que busca en la documentación interna, un agente que consulta una base de datos y redacta un informe, un flujo que procesa facturas. Construirlos exige combinar recuperación de información, memoria, herramientas externas y protocolos como MCP, además de medir la calidad del conjunto y no solo de cada pieza.
Evaluar, explicar y cumplir la normativa
Con modelos clásicos, técnicas como SHAP o LIME ayudan a explicar por qué un modelo decide lo que decide. Con modelos generativos, el reto es otro: detectar alucinaciones, medir la calidad de las respuestas con conjuntos de evaluación y jueces automáticos, y probar el sistema frente a ataques como la inyección de instrucciones.
La regulación acompaña. Además del RGPD, el Reglamento Europeo de IA (AI Act) está en vigor desde agosto de 2024 y sus obligaciones se aplican de forma escalonada. El ómnibus digital aprobado en 2026 retrasó las de los sistemas de alto riesgo a diciembre de 2027 y agosto de 2028, según el tipo de sistema. Para quien diseña sistemas de IA, cumplir no es un trámite final: se traduce en decisiones de arquitectura desde el principio.
Coste, nube y eficiencia
La nube sigue siendo el entorno natural para entrenar y servir modelos, pero el coste por consulta de un modelo grande obliga a optimizar. Ganan peso los modelos más pequeños, la cuantización, la caché de respuestas y la ejecución en el propio dispositivo cuando la latencia o la privacidad lo exigen.
Qué habilidades se piden ahora
- Fundamentos que no caducan: estadística, aprendizaje automático y evaluación rigurosa.
- Python y SQL con soltura.
- Trabajo con modelos de lenguaje: instrucciones, RAG, agentes y uso de herramientas.
- Evaluación y seguridad de sistemas generativos.
- Despliegue y operación: contenedores, monitorización, control de costes.
- Criterio ético y normativo, y capacidad para explicar decisiones técnicas a personas que no lo son.